serie: IA de cero a experto | artículo 4 de 30Antes de meternos en machine learning clásico, redes neuronales y modelos de lenguaje, toca un capítulo distinto a los anteriores: nada de historia, nada de filosofía, solo las matemáticas para IA mínimas, la caja de herramientas necesaria para que el resto de la serie se entienda de verdad. Sin fórmulas pesadas, sin exámenes, sin nostalgia de la universidad. Solo la intuición de tres ideas: vectores, matrices y probabilidad.
No es casualidad que la IA moderna se apoye precisamente en estas tres ramas de las matemáticas y no en otras. El álgebra lineal (vectores y matrices) da una forma compacta y muy eficiente de representar y transformar cantidades enormes de datos a la vez, algo que los ordenadores hacen especialmente rápido gracias a hardware pensado justo para eso. La probabilidad, por su parte, da un lenguaje formal para que un sistema exprese lo seguro o inseguro que está de algo, en vez de fingir una certeza que no tiene. Entre las dos cubren, a nivel de intuición, casi todo lo que necesitas para que el resto de esta serie tenga sentido.
Vectores
Un vector es, en su forma más simple, una lista ordenada de números. Nada más exótico que eso. La geometría añade una capa extra de intuición muy útil: un vector también se puede pensar como una flecha con una dirección y una magnitud concretas, ancladas en un espacio con tantas dimensiones como números tenga la lista. Esa doble lectura (lista de números por un lado, flecha en el espacio por otro) es la base de toda la serie de vídeos «Essence of Linear Algebra» de Grant Sanderson, más conocido como 3Blue1Brown, que sigue siendo, años después de publicada, una de las explicaciones más citadas de esta idea en internet.
¿Por qué le importa esto a la IA? Porque casi todo lo que un modelo procesa, antes de nada, se convierte en vectores. Una imagen se convierte en un vector larguísimo de valores de intensidad de píxel. Una palabra se convierte en un vector de números que captura, de alguna forma abstracta, su significado. Este segundo caso tiene un ejemplo que se ha hecho célebre en el campo: en 2013, un equipo de Google formado por Tomas Mikolov, Kai Chen, Greg Corrado y Jeffrey Dean publicó un sistema llamado word2vec, capaz de representar palabras como vectores de forma que las relaciones entre significados se comportaran como operaciones aritméticas. El ejemplo que se repite en cualquier introducción al tema, documentado en un trabajo relacionado del mismo Mikolov junto con Wen-tau Yih y Geoffrey Zweig: si coges el vector de «rey», le restas el vector de «hombre» y le sumas el vector de «mujer», el resultado queda muy cerca del vector de «reina», sin que nadie le haya explicado al sistema qué es la realeza o el género. Vale la pena el matiz honesto: ese resultado tan limpio depende de excluir las palabras originales de la búsqueda del vecino más cercano. Si no se excluyen, el resultado más cercano suele ser, literalmente, «rey» otra vez. Aun con ese matiz, la idea de fondo se sostiene y sigue siendo una de las demostraciones más citadas de que el significado se puede capturar, hasta cierto punto, con números y geometría.
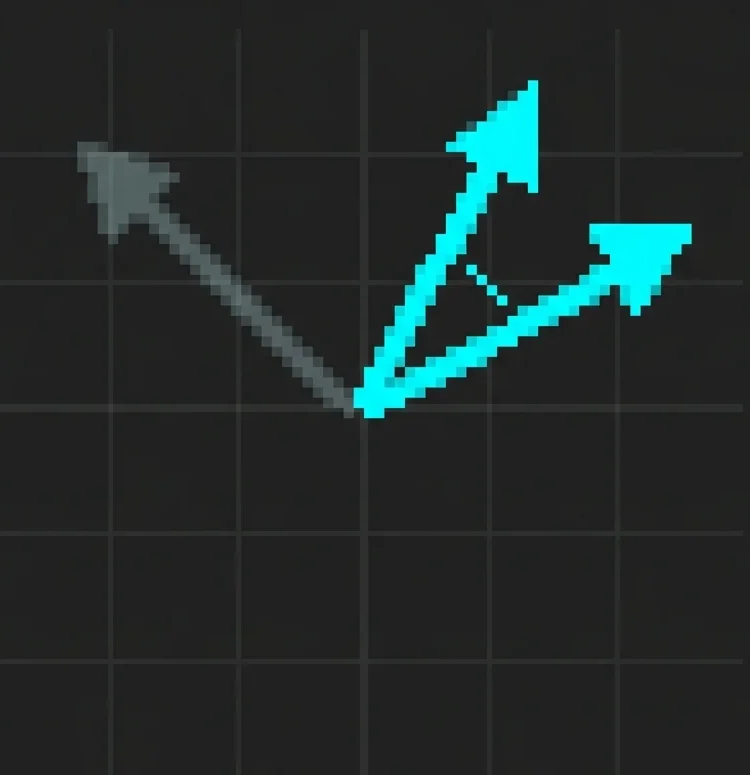
Una vez que dos cosas cualquiera (dos palabras, dos imágenes, dos usuarios de una tienda online) están representadas como vectores, aparece una pregunta muy práctica: ¿cómo de parecidos son? La respuesta habitual es medir el ángulo entre ambos vectores, no la distancia entre sus puntas. Cuanto más pequeño el ángulo, más apuntan en la misma dirección, más «parecidos» son en lo que sea que ese espacio esté representando. A esto se le llama similitud coseno, y es, literalmente, el mecanismo que hay detrás de un motor de recomendación básico: tus gustos se convierten en un vector, los de miles de productos también, y el sistema te recomienda aquello cuyo vector apunta en una dirección más parecida a la tuya. No hace falta que recuerdes el nombre técnico. Sí conviene que te quede la idea: en el espacio de los vectores, «parecido» tiene una definición geométrica concreta, no es una sensación vaga.
Los vectores que manejan los modelos de IA reales casi nunca tienen dos o tres números, como los ejemplos que se dibujan en una pizarra con flechas. Un modelo de lenguaje moderno suele representar cada palabra con un vector de varios cientos o incluso miles de números. Nadie puede dibujar ni visualizar mentalmente una flecha en un espacio de 1.536 dimensiones, y no hace falta: las matemáticas de vectores, ángulos y distancias funcionan exactamente igual con dos dimensiones que con mil quinientas, aunque nuestra intuición geométrica se quede corta a partir de la tercera. La flecha en la pizarra es solo un andamio para entender la idea, no una limitación real del concepto.
Matrices
Si un vector es una lista de números, una matriz es una tabla de números, filas por columnas. Pero la forma más útil de pensar en una matriz, para lo que viene en esta serie, no es como una tabla de datos estática, sino como una función: algo que coge un vector y lo transforma en otro vector distinto. Multiplicar un vector por una matriz mueve ese vector a un lugar nuevo del espacio, lo estira, lo rota o lo aplasta, dependiendo de qué números tenga la matriz. Una matriz muy simple puede, por ejemplo, coger cualquier vector y devolverlo del revés, o duplicar todos sus valores, o aplastarlo hasta convertirlo casi en un punto. Cada una de esas operaciones geométricas corresponde a una tabla de números concreta.
Cuando una app de fotos rota una imagen, la endereza o la estira para que quepa en un marco distinto, por debajo está aplicando exactamente este tipo de transformación a la tabla de números que representa esa imagen, píxel a píxel. La diferencia entre eso y una red neuronal no es el tipo de operación (multiplicar vectores por matrices), es que en la red neuronal nadie decidió a mano los números de la matriz para conseguir un efecto concreto como «rotar 90 grados»: esos números se ajustan solos, automáticamente, durante el entrenamiento, hasta que la transformación resultante hace lo que se le pidió (reconocer un gato, traducir una frase, lo que sea), sin que ningún humano haya escrito esa regla explícitamente. Es la misma matemática que llevas usando sin saberlo cada vez que giras una foto en el móvil, solo que aplicada a una escala y con un propósito completamente distintos.
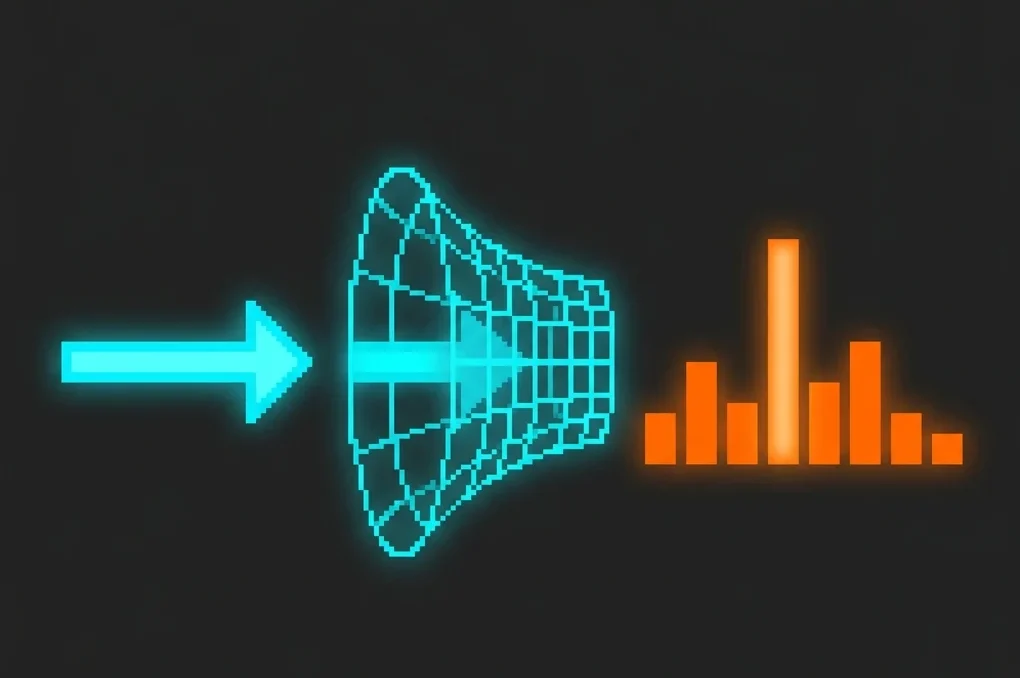
Esta idea es literalmente lo que hace, capa a capa, una red neuronal (que verás con detalle en el capítulo 11): cada capa aplica una transformación matricial a los datos que recibe, y el entrenamiento del modelo no es otra cosa que ir ajustando los números de esas matrices (los «pesos» del modelo) hasta que la transformación completa, de principio a fin, convierte una entrada (una imagen, un texto) en la salida correcta. Cuando leas que un modelo de lenguaje tiene «70.000 millones de parámetros», lo que en realidad se está describiendo es el tamaño total de todas esas matrices sumadas: 70.000 millones de números individuales, cada uno ajustado durante el entrenamiento para que la transformación completa funcione. El libro de referencia académica más citado sobre esto, Mathematics for Machine Learning, de Deisenroth, Faisal y Ong (Cambridge University Press, 2020, disponible gratis online), dedica sus primeros capítulos enteros a construir precisamente esta intuición antes de tocar ningún algoritmo de machine learning propiamente dicho. No es casualidad el orden: sin esto, lo que viene después se aprende de memoria en vez de entenderse.
Vectores y matrices tienen, además, un nombre común más general que te vas a encontrar constantemente en cuanto leas o veas código de IA: tensor. Un tensor no es más que una generalización de la misma idea a cualquier número de dimensiones: un número suelto es un tensor de orden cero, un vector es un tensor de orden uno, una matriz es un tensor de orden dos, y una tabla de números con tres, cuatro o más ejes (por ejemplo, una colección de imágenes en color, donde hace falta un eje para el alto, otro para el ancho, otro para el color y otro más para cuántas imágenes hay) es un tensor de orden superior. No hace falta imaginarlo geométricamente más allá de la matriz, basta con quedarse con la idea de tabla de números con varios ejes. El nombre no es casualidad: las dos librerías de programación más usadas para construir modelos de IA se llaman TensorFlow (de Google) y PyTorch, cuyo tipo de dato central se llama, literalmente, tensor. Todo lo que has visto en esta sección sobre vectores y matrices es, en el fondo, el caso particular más simple de esa misma idea.
Probabilidad
La probabilidad es la tercera pieza, y es la más distinta de las tres porque no describe objetos (vectores, matrices) sino incertidumbre. Un modelo de machine learning casi nunca te da una respuesta con un cien por cien de certeza: te da una probabilidad, un número entre 0 (imposible) y 1 (seguro), de que algo sea cierto. El filtro de spam del capítulo 1 no decide de forma binaria y tajante que un correo es spam: calcula una probabilidad de que lo sea, y aplica un umbral (por ejemplo, si supera el 90%, lo manda a la carpeta de spam) para convertir esa probabilidad en una decisión concreta. Ese umbral es una elección de diseño, no una ley física, y moverlo hacia arriba o hacia abajo cambia cuántos correos legítimos se cuelan como spam y cuántos spam se cuelan como legítimos: subir el umbral reduce los falsos positivos pero deja pasar más spam de verdad, bajarlo hace lo contrario. No existe un umbral «correcto» universal, solo compensaciones distintas según qué error te preocupe más evitar. Volveremos sobre este umbral, con nombre y detalle, en las métricas de evaluación del capítulo 8.
La probabilidad de un modelo no es una medida de verdad objetiva del mundo, es una medida de confianza del propio modelo, calculada a partir de los datos con los que se entrenó. Un modelo puede estar muy seguro (una probabilidad alta) y equivocarse igualmente, si sus datos de entrenamiento tenían sesgos o huecos. Alta probabilidad no es sinónimo de verdad garantizada, es sinónimo de «esto encaja mucho con los patrones que este modelo concreto ha visto antes».
No hace falta ningún dato de IA para ver por qué importa esta distinción, solo aritmética. Imagina una prueba médica con un 99% de precisión para detectar una enfermedad que afecta a 1 de cada 10.000 personas. Si te da positivo, ¿qué probabilidad hay de que realmente la tengas? La intuición dice que casi el 99%. La aritmética dice otra cosa: sobre 10.000 personas, solo 1 tiene la enfermedad de verdad (y la prueba probablemente la detecta), pero de las 9.999 personas sanas, un 1% (unas 100 personas) recibirán igualmente un positivo por error. Así que, de aproximadamente 101 positivos totales, solo 1 es real: la probabilidad de estar realmente enfermo tras un positivo ronda el 1%, no el 99%. Este fenómeno tiene nombre propio en estadística, la falacia de la tasa base (base rate fallacy): ignorar lo rara que es una condición de partida lleva a sobreestimar muchísimo lo fiable que es un resultado positivo. Este mismo tipo de aritmética, aplicada a la escala de millones de decisiones automatizadas (un sistema de detección de fraude bancario, un filtro de contenido, un diagnóstico por imagen), es exactamente lo que hace que la precisión de un modelo por sí sola, sin más contexto sobre cómo de frecuente es lo que busca detectar, sea una cifra que engaña con mucha facilidad. Volveremos sobre esto con más detalle, y con nombres concretos para cada tipo de error, en el capítulo 8.
Dejamos fuera el cálculo diferencial (derivadas, gradiente) para verlo en capítulos posteriores. Tampoco entramos en estadística más allá de la probabilidad básica.
Y aquí es donde las tres piezas dejan de ser tres capítulos sueltos y se convierten en una sola tubería, que es exactamente como funciona un modelo de lenguaje moderno, a grandes rasgos y sin entrar en detalle todavía: tu texto se convierte en vectores, esos vectores atraviesan capa tras capa de matrices que los van transformando, y al final de esa tubería el modelo no escupe una palabra fija, escupe una probabilidad distinta para cada palabra posible del idioma, y elige (o casi elige, con algo de aleatoriedad calculada de por medio) la más probable, o una de las más probables. Vector, matriz, probabilidad, en ese orden, una y otra vez, capa tras capa.
Con estas tres piezas (vectores como forma de representar información, matrices como forma de transformarla, probabilidad como forma de cuantificar la incertidumbre del resultado) tienes las matemáticas para IA mínimas que necesitas para que el resto de la serie deje de sonar a magia y empiece a sonar a ingeniería, que es lo que realmente es. No necesitas saber calcular a mano el producto de dos matrices ni memorizar la fórmula del teorema de Bayes para seguir el resto de esta serie. Necesitas, únicamente, que estas tres palabras (vector, matriz, probabilidad) dejen de sonar a jerga y empiecen a sonar a herramientas con un trabajo concreto que hacer, porque en los próximos capítulos vas a verlas aparecer una y otra vez, aplicadas a problemas cada vez más concretos.
En el próximo capítulo arranca de verdad la fase 1: aprendizaje supervisado, no supervisado y por refuerzo, las tres escuelas del machine learning clásico.
Fuentes
- Grant Sanderson (3Blue1Brown), «Essence of Linear Algebra»
- Mikolov, Chen, Corrado, Dean, «Efficient Estimation of Word Representations in Vector Space» (2013)
- Mikolov, Yih, Zweig, «Linguistic Regularities in Continuous Space Word Representations» (NAACL 2013)
- Deisenroth, Faisal, Ong, «Mathematics for Machine Learning» (Cambridge University Press, 2020)