serie: IA de cero a experto | artículo 7 de 30Entrenar no es darle datos a una máquina y esperar. Es un proceso con reglas
Qué significa entrenar
El capítulo 6 dejó cuatro algoritmos sobre la mesa y una frase repetida sin explicar, «se entrena con los datos». Toca abrir esa caja. Entrenar un modelo es el proceso por el que un algoritmo ajusta sus propios números internos, sus parámetros, hasta que sus predicciones sobre unos datos de ejemplo se parecen lo máximo posible a las respuestas correctas que ya conocemos.
Dicho así suena a magia. No lo es, es un bucle bastante tonto repetido muchísimas veces. El modelo hace una predicción, se compara con la respuesta real, se mide cuánto ha fallado con una función que se llama función de pérdida, y se ajustan los parámetros en la dirección que reduce ese fallo. Otra vez. Y otra. El proceso termina cuando el error deja de bajar de forma apreciable o cuando se acaba el presupuesto de tiempo y cómputo, que en la práctica es el criterio que manda más a menudo de lo que se admite.
Lo importante de este capítulo no es el bucle. Es todo lo que hay alrededor, las decisiones que se toman antes y después, porque ahí es donde se gana o se pierde un proyecto de machine learning. Qué datos entran, en qué forma entran, cómo se comprueba que el resultado sirve para algo, y por qué un modelo que acierta el 100% de las veces suele ser una señal de que algo va muy mal.
Bajar la montaña con niebla
La analogía habitual para el ajuste de parámetros es una montaña, y funciona bien porque el problema es literalmente geométrico. Imagina un paisaje de colinas y valles donde la altura de cada punto representa cuánto se equivoca el modelo con una combinación concreta de parámetros. Los valles son configuraciones buenas, con poco error. Las cumbres son configuraciones malas. Entrenar consiste en encontrar el fondo de un valle.
El problema es que no puedes ver el paisaje entero. Estás en un punto cualquiera, con niebla espesa, y lo único que puedes hacer es palpar el suelo bajo tus pies para saber hacia dónde baja la pendiente, dar un paso en esa dirección, y repetir. Eso es el descenso de gradiente, el procedimiento que mueve el mundo del machine learning moderno. El «gradiente» es la dirección de máxima pendiente en ese punto concreto, y el algoritmo la calcula, se mueve un poco en sentido contrario, y vuelve a mirar.
El tamaño de cada paso importa muchísimo y se llama tasa de aprendizaje. Pasos demasiado pequeños y el entrenamiento tarda una eternidad en llegar abajo. Pasos demasiado grandes y el modelo salta de un lado a otro del valle sin llegar nunca al fondo, o directamente sale disparado ladera arriba. No hay un valor universalmente bueno, depende del problema.
La otra complicación de la niebla es que puedes acabar en el fondo de un valle pequeño creyendo que es el punto más bajo de todo el paisaje. En jerga, un mínimo local en vez del mínimo global. Durante años se dio por hecho que ese era el gran obstáculo del entrenamiento, y un trabajo de Yann Dauphin y otros presentado en NeurIPS 2014 argumentó lo contrario. En espacios de dimensión muy alta, los puntos críticos tienen muchísima más probabilidad de ser puertos de montaña, puntos de silla, que mínimos locales de verdad. Un punto de silla baja en unas direcciones y sube en otras, y rodeado de mesetas casi planas puede frenar el entrenamiento durante mucho tiempo dando la impresión falsa de haber llegado al fondo. La posibilidad de quedarse atascado sigue ahí, y explica por qué dos entrenamientos del mismo modelo con distinto punto de partida pueden acabar en sitios distintos.
Parámetros e hiperparámetros, dos cosas diferentes
Merece la pena separar dos palabras que suenan parecidas y se confunden constantemente.
Los parámetros son los números que el modelo aprende solo durante el entrenamiento. Los coeficientes de una regresión, los pesos de una red neuronal. Nadie los escribe a mano, salen del bucle de arriba. Cuando alguien dice que un modelo de lenguaje tiene setenta mil millones de parámetros, se refiere exactamente a esto, a la cantidad de números ajustables que contiene.
Los hiperparámetros son las decisiones de configuración que se toman antes de entrenar y que el modelo no puede aprender por su cuenta. La tasa de aprendizaje del apartado anterior es un hiperparámetro. La profundidad máxima de un árbol de decisión, un hiperparámetro. Cuántos grupos k le pides a un k-means, un hiperparámetro. Son las perillas del panel de control, y ajustarlas bien tiene tanto impacto en el resultado final como elegir el algoritmo.
La forma tosca de ajustarlos es probar combinaciones a lo bruto y quedarse con la mejor. Hay métodos más elegantes, pero todos comparten un requisito que enlaza con el siguiente apartado, para comparar configuraciones necesitas datos que el modelo no haya visto, y necesitas no gastar en esa comparación los datos que reservaste para la evaluación final.
Los datos entran en forma de features
Un algoritmo no entiende «una vivienda», ni «un cliente», ni «un correo electrónico». Entiende números. La traducción de un objeto del mundo real a una lista de números que el algoritmo pueda digerir es lo que se llama representación en features, o características. Cada feature es una columna, una variable medible del objeto.
Para una vivienda, las features obvias son metros cuadrados, número de habitaciones, año de construcción, planta. Para un correo, podrían ser el número de enlaces, la presencia de ciertas palabras, la hora de envío, si el remitente está en la libreta de direcciones. Esa lista de números por cada ejemplo es exactamente el vector del que hablaba el capítulo 4, y el modelo nunca ve nada más que eso.
Aquí aparece la parte del oficio que ninguna herramienta automatiza del todo, la ingeniería de features. Consiste en decidir qué se mide y cómo se transforma antes de entregárselo al algoritmo. Un ejemplo concreto, si tienes la fecha de nacimiento de un cliente, entregarle al modelo el número 19870324 no le dice nada útil. Convertirlo en edad sí. Y en algunos problemas, convertirlo en tramos de edad dice todavía más que la edad exacta. La información es la misma, la forma en la que se presenta cambia por completo lo que el modelo puede aprender de ella.
Hay transformaciones que no son opcionales. Si una feature va de 0 a 1 y otra va de 0 a 500.000, muchos algoritmos van a considerar la segunda muchísimo más importante solo por la escala de sus números, sin ninguna razón de fondo. Por eso se normalizan, se llevan todas a un rango comparable. Las variables que no son numéricas, como el país o el tipo de producto, necesitan su propia conversión a números que no invente un orden falso, porque codificar España como 1 y Francia como 2 le sugiere al modelo que Francia es el doble de algo.
Este trabajo previo, poco glamuroso y muy manual, se lleva una porción enorme del tiempo de un proyecto real. Conviene una nota de precisión sobre la cifra que se repite en charlas y artículos, esa de que los científicos de datos dedican el 80% del tiempo a limpiar datos. Esa cifra circula sin una fuente primaria clara detrás. Las encuestas del sector que sí publican reparto de tiempo, como el State of Data Science de Anaconda, han situado la preparación de datos en el entorno del 40 al 45% de la jornada según el año. Sigue siendo la actividad individual más costosa, y sigue sin ser el 80% que se cita de memoria. El capítulo 9 entra a fondo en por qué esta fase pesa tanto.
El conjunto de datos se parte en dos, como mínimo
Aquí está la idea que separa a alguien que ha entrenado un modelo de alguien que ha entrenado un modelo que sirve para algo.
Si entrenas con todos los datos disponibles y luego mides el acierto sobre esos mismos datos, el número que obtienes no significa nada. Es como corregir un examen a alguien que se ha estudiado las respuestas de ese examen concreto. Un buen resultado no demuestra que haya entendido la materia, demuestra que tiene buena memoria.
La solución estándar es partir los datos antes de empezar. Una parte, la mayoritaria, se usa para entrenar. Otra, que el modelo no ve durante el entrenamiento, se reserva para evaluarlo después. Ese conjunto reservado es el conjunto de prueba, y su nota es la única que se puede tomar en serio, porque son ejemplos nuevos para el modelo. En proyectos serios hay una tercera partición, el conjunto de validación, que se usa para tomar decisiones intermedias, como elegir entre varias configuraciones, de forma que el conjunto de prueba se toca una sola vez al final y sigue siendo un examen limpio.
Cuando hay pocos datos, reservar una parte duele. Para eso existe la validación cruzada, formalizada por M. Stone en 1974 en el Journal of the Royal Statistical Society. La idea consiste en partir los datos en varios bloques, entrenar varias veces rotando cuál de los bloques hace de examen, y promediar los resultados. Así todos los ejemplos acaban usándose para entrenar y para evaluar, aunque nunca a la vez en la misma ronda.
Hay una forma silenciosa de romper todo esto que tiene nombre propio, la fuga de datos o data leakage. Ocurre cuando información del conjunto de prueba se cuela en el entrenamiento sin que nadie se dé cuenta, por ejemplo si normalizas todas las features usando la media de todo el conjunto antes de partirlo, o si el mismo cliente aparece en las dos partes con registros distintos. El síntoma es un resultado sospechosamente bueno en pruebas y un batacazo en producción.
Una variante especialmente traicionera aparece con datos que tienen orden temporal. Si estás prediciendo qué clientes se van a dar de baja el mes que viene y repartes las filas al azar entre entrenamiento y prueba, el modelo acaba entrenando con hechos de marzo para predecir febrero. En el examen sale brillante. En la realidad, donde el futuro todavía no ha ocurrido, no tiene esa ventaja. Con series temporales la partición se hace por fecha, entrenar con el pasado, evaluar con el futuro, igual que funcionará el día que se despliegue.
Y hay un detalle que se olvida al salir del laboratorio. El mundo cambia, así que un modelo entrenado con datos de hace dos años puede degradarse sin que nadie toque una línea de código, simplemente porque los patrones de comportamiento que aprendió ya no son los actuales. Ese fenómeno tiene nombre, deriva o drift, y es la razón por la que un modelo en producción no es un producto terminado sino algo que hay que vigilar y reentrenar.
Overfitting, cuando el modelo memoriza
Un modelo puede fallar de dos maneras opuestas, y ambas tienen nombre.
El subajuste, o underfitting, es el caso fácil de detectar. El modelo es demasiado simple para el patrón que hay en los datos, y falla en todas partes, también en el entrenamiento. Intentar describir con una línea recta algo que claramente dibuja una curva. Se detecta rápido porque los números son malos desde el principio.
El sobreajuste, u overfitting, es el problema de verdad. El modelo tiene suficiente capacidad para aprenderse los datos de entrenamiento de memoria, ejemplo por ejemplo, incluyendo el ruido, los errores de medición y las casualidades que no se van a repetir. En el entrenamiento acierta casi todo. En datos nuevos, se desploma. Ha aprendido el examen, no la materia.
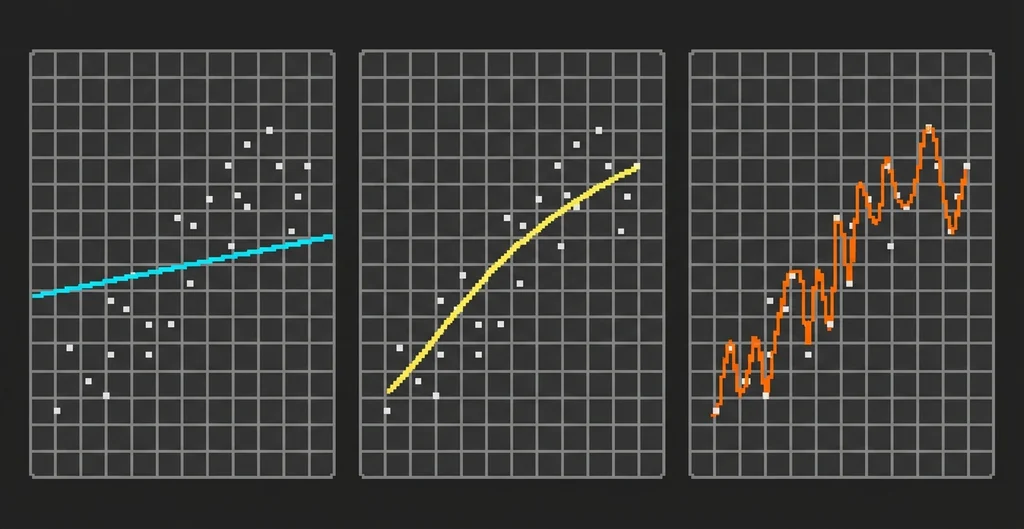
Entre esos dos extremos hay una tensión que tiene formulación formal en el campo. Stuart Geman, Elie Bienenstock y René Doursat la describieron en 1992 en «Neural Networks and the Bias/Variance Dilemma», publicado en Neural Computation, como el dilema entre sesgo y varianza. Un modelo muy rígido tiene sesgo alto, se equivoca siempre de la misma manera porque su forma no da para más. Un modelo muy flexible tiene varianza alta, cambia radicalmente si le cambias un poco los datos de entrenamiento, porque se está adaptando a detalles que no importan. El punto bueno está en el medio, y encontrarlo es buena parte del trabajo.
Las herramientas para combatir el sobreajuste son unas cuantas y todas apuntan en la misma dirección, limitar la libertad del modelo o darle más ejemplos. Más datos de entrenamiento, porque cuanto más variado es lo que ha visto, menos puede memorizarlo. Regularización, que son penalizaciones matemáticas a los modelos innecesariamente complicados. Parada temprana, cortar el entrenamiento cuando el error en validación empieza a subir aunque el de entrenamiento siga bajando, que es la señal clásica de que el modelo ha empezado a memorizar. Y en el caso de los árboles del capítulo anterior, poda y bosques.
No existe el mejor algoritmo
Queda una pregunta razonable. Si hay cuatro algoritmos clásicos y muchos más que no cabían en el capítulo 6, ¿cuál es el bueno?
La respuesta tiene demostración matemática y suele decepcionar. David Wolpert publicó en 1996 en Neural Computation un trabajo que se conoce popularmente como el teorema del «no free lunch» para el aprendizaje. Su conclusión, dicho en corto y perdiendo precisión por el camino, es que ningún algoritmo de aprendizaje es superior a otro promediando sobre todos los problemas posibles. Para cada problema en el que A gana a B, existe otro en el que B gana a A.
Lo que esto significa en la práctica no es que dé igual lo que elijas. Significa que la superioridad de un algoritmo siempre es relativa a un tipo de problema y a una forma concreta de los datos, nunca absoluta. Por eso el flujo de trabajo real no es elegir el mejor algoritmo sobre el papel, es probar varios candidatos razonables sobre los mismos datos partidos de la misma forma y comparar sus resultados con la misma métrica.
Y ahí aparece la trampa siguiente, que ocupa el capítulo 8 entero. Comparar resultados exige elegir una métrica, y la métrica equivocada puede hacer que un modelo inútil parezca excelente.