serie: IA de cero a experto | artículo 6 de 30Cuatro algoritmos que llevan décadas funcionando y que no necesitan una sola red neuronal.
La caja de herramientas
En el capítulo 5 quedaron sobre la mesa las tres escuelas del machine learning, supervisado, no supervisado y por refuerzo. Eran tres formas de plantear un problema, no tres formas de resolverlo. Este capítulo baja un piso y entra en la sala de máquinas, los algoritmos de machine learning clásicos que llevan décadas resolviendo problemas reales dentro de esas escuelas.
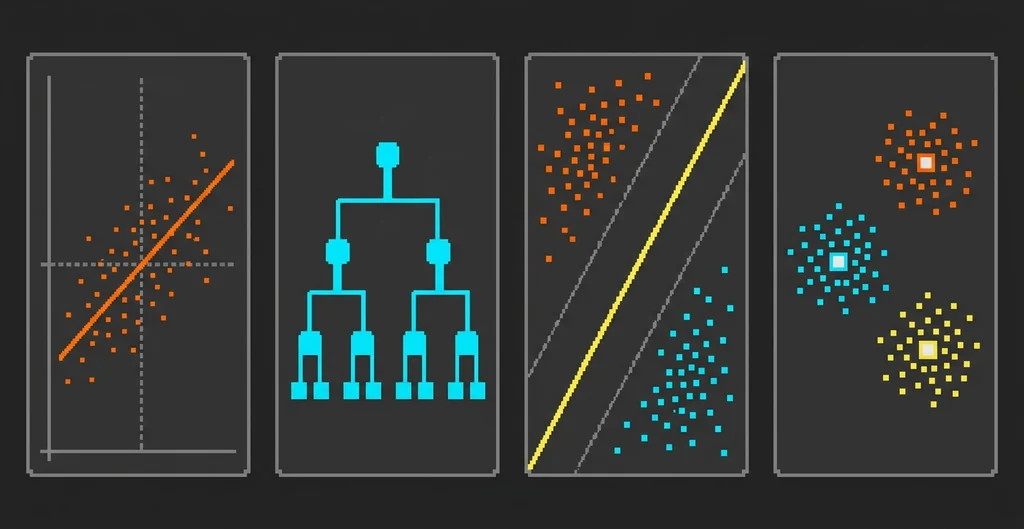
Cuatro nombres que aparecen en cualquier temario de machine learning y en cualquier oferta de empleo de data science, regresión, árboles de decisión, máquinas de vectores de soporte y k-means. Los tres primeros son supervisados, el cuarto es no supervisado. Ninguno de los cuatro es una red neuronal y ninguno de los cuatro necesita una GPU para funcionar.
Conviene desactivar de entrada una idea equivocada muy extendida. Estos algoritmos no son la prehistoria de la IA, ni una parada obligatoria antes de llegar a lo bueno. Se usan hoy, en producción, en empresas que también tienen modelos de deep learning corriendo en el mismo edificio. La razón está al final de este capítulo, con un benchmark reciente que la respalda. Antes toca entender qué hace cada uno y qué problema resuelve.
Regresión, la recta que mejor encaja
La regresión es el algoritmo más antiguo de los cuatro por un margen cómodo de casi dos siglos. El método de mínimos cuadrados, que es su motor matemático, apareció publicado por primera vez en 1805, en un apéndice titulado «Sur la Méthode des moindres quarrés» dentro de un libro de Adrien-Marie Legendre sobre cómo calcular las órbitas de los cometas. No había ordenadores, no había datos masivos, había astrónomos intentando encajar una curva en un puñado de observaciones tomadas a mano con un telescopio.
El nombre «regresión» llegó ochenta años más tarde y por un camino inesperado. Francis Galton publicó en 1886 un estudio sobre estaturas heredadas en el Journal of the Anthropological Institute, donde observó que los hijos de padres muy altos tendían a ser altos, pero menos que sus padres, y los hijos de padres muy bajos tendían a ser bajos, pero menos que sus padres. Las estaturas «regresaban» hacia la media de la población. De ese fenómeno biológico salió la palabra que hoy usa toda la industria del machine learning para nombrar algo bastante más aburrido que la herencia genética.
La idea es sencilla de visualizar. Tienes una nube de puntos en un gráfico, por ejemplo el tamaño de una vivienda en un eje y su precio en el otro. La regresión lineal busca la recta que pasa lo más cerca posible de todos esos puntos a la vez. «Lo más cerca posible» tiene una definición precisa, se mide la distancia vertical de cada punto a la recta, se eleva al cuadrado para que los errores por arriba y por abajo no se cancelen entre sí, y se busca la recta que minimiza la suma de todos esos cuadrados. De ahí el nombre del método.
Con esa recta ya trazada, predecir es trivial. Llega una vivienda nueva con un tamaño concreto, miras qué precio le corresponde en la recta y ya tienes tu estimación. En la práctica casi nunca hay una sola variable de entrada, sino decenas (tamaño, número de habitaciones, antigüedad, distancia al centro), y entonces la recta deja de ser una recta y se convierte en un plano o en algo equivalente en más dimensiones. La intuición no cambia, sigues buscando la superficie que mejor encaja con la nube.
Existe una variante para clasificación, la regresión logística, que resuelve un problema distinto pese al nombre. En lugar de escupir un número cualquiera, transforma su salida en un valor entre 0 y 1 que se interpreta como probabilidad de pertenecer a una clase. Es el algoritmo que responde a la pregunta «qué probabilidad hay de que este correo sea spam», con un número, no con un sí o un no rotundo. Sigue siendo la primera herramienta que se prueba en muchísimos problemas de clasificación binaria de la industria.
La gran ventaja de la regresión es la interpretabilidad. El modelo entrenado es literalmente una lista de coeficientes, uno por variable, y cada coeficiente te dice cuánto sube o baja la predicción cuando esa variable cambia. Puedes enseñarle el modelo a alguien de negocio y que entienda por qué predice lo que predice. Con una red neuronal de mil millones de parámetros esa conversación es bastante más incómoda.
La gran limitación es la otra cara de lo mismo. La regresión lineal asume que la relación entre entradas y salida es una línea recta, y el mundo real está lleno de relaciones que no lo son. Cuando los datos tienen una forma retorcida, la mejor recta posible sigue siendo una mala recta.
Árboles de decisión, un cuestionario que se escribe solo
Un árbol de decisión funciona como un cuestionario encadenado. ¿La transacción supera los 500 euros? Si es que sí, ¿se hizo fuera del país habitual del cliente? Si es que sí, ¿ocurrió entre las 3 y las 5 de la madrugada? Cada respuesta te lleva a otra pregunta, hasta llegar al final de una rama, donde hay una conclusión. Fraude o no fraude.
Lo interesante no es la estructura, que cualquiera podría dibujar en una servilleta. Lo interesante es que el algoritmo decide solo qué preguntas hacer y en qué orden, a partir de los datos de entrenamiento. En cada nodo prueba todas las divisiones posibles de todas las variables disponibles y se queda con la que mejor separa los datos, la que deja los grupos resultantes más «puros», con menos mezcla de clases. Luego repite el proceso dentro de cada grupo, y así hasta que no merece la pena seguir dividiendo.
El detalle de cómo se mide esa pureza es donde se bifurca la historia del algoritmo, porque los árboles de decisión se desarrollaron dos veces en paralelo, en dos comunidades que apenas se leían entre sí. Por el lado de la estadística, Leo Breiman, Jerome Friedman, Richard Olshen y Charles Stone publicaron en 1984 el libro «Classification and Regression Trees», que dio nombre al enfoque CART y que mide la pureza con el índice de Gini. Por el lado del machine learning, Ross Quinlan publicó en 1986 el artículo «Induction of Decision Trees» en el primer volumen de la revista Machine Learning, describiendo el sistema ID3, que mide la pureza con la entropía tomada de la teoría de la información. Dos culturas, dos vocabularios, el mismo animal.
Los árboles tienen una virtud que ningún otro algoritmo de esta lista iguala. Son auditables de verdad. Puedes imprimir el árbol entrenado, leerlo de arriba abajo y explicar cada decisión concreta que toma el modelo con un dedo sobre el papel. En sectores donde una decisión automática tiene que justificarse ante un regulador o ante un cliente, eso no es un detalle estético, es un requisito.
También tienen un defecto grave. Un árbol al que se le deja crecer sin control acaba haciendo una pregunta a medida para cada ejemplo del entrenamiento, memorizando en vez de aprender. Es el problema que el capítulo 7 tratará con nombre propio, el sobreajuste. La solución habitual no es podar un árbol hasta dejarlo perfecto, es la fuerza bruta elegante de entrenar cientos de árboles distintos, cada uno con una porción diferente de los datos y de las variables, y hacer que voten. Eso es un bosque aleatorio, y su versión más agresiva, el gradient boosting, construye los árboles en cadena, cada uno especializado en corregir los errores que dejó el anterior. Las implementaciones modernas de esta familia son las que aparecen una y otra vez en los primeros puestos de las competiciones de datos tabulares. La más conocida es XGBoost, presentada por Tianqi Chen y Carlos Guestrin en 2016, que sus propios autores describen como un sistema usado de forma masiva por científicos de datos para conseguir resultados punteros en competiciones de machine learning.
SMV, el pasillo más ancho posible
Las máquinas de vectores de soporte, SVM por sus siglas en inglés, resuelven un problema de clasificación con una idea geométrica muy concreta. Si tienes dos grupos de puntos y quieres separarlos con una línea, hay infinitas líneas que lo consiguen. La pregunta que se hace una SVM es cuál de todas esas líneas es la mejor, y su respuesta es la que deja el pasillo más ancho entre los dos grupos. En jerga, la que maximiza el margen.
La intuición detrás de esa elección es sólida. Una frontera que pasa rozando los puntos de un grupo funcionará con los datos de entrenamiento, pero cualquier ejemplo nuevo ligeramente desplazado caerá del lado equivocado. Una frontera centrada en un pasillo ancho tiene margen de error por los dos lados. Los puntos que tocan el borde de ese pasillo, los que están justo en la frontera de lo posible, son los «vectores de soporte» que dan nombre al algoritmo. El resto de puntos, los que están lejos y cómodos dentro de su grupo, no influyen en absoluto en dónde acaba la línea. El algoritmo se define por sus casos límite.
El algoritmo de entrenamiento se presentó en 1992, en el artículo «A Training Algorithm for Optimal Margin Classifiers» de Bernhard Boser, Isabelle Guyon y Vladimir Vapnik, dentro del workshop COLT. Ese mismo artículo trae la pieza que convirtió a las SVM en el algoritmo de referencia de toda una época, el truco del kernel. Tres años después, Corinna Cortes y Vladimir Vapnik publicaron «Support-Vector Networks» en la revista Machine Learning, añadiendo el margen blando, la tolerancia a que algunos puntos caigan del lado equivocado de la frontera. Eso es lo que hizo utilizable el método con datos que no se pueden separar limpiamente, que es la situación normal fuera de un ejemplo de libro.
El truco del kernel merece su propia explicación. Imagina puntos rojos y azules sobre una mesa, con los rojos formando un anillo alrededor de los azules. No hay ninguna línea recta sobre esa mesa que los separe. Pero si levantas los puntos azules por encima de la mesa y dejas los rojos abajo, de repente sí puedes separarlos con una hoja de papel horizontal. El truco del kernel hace exactamente eso, proyecta los datos a un espacio de muchas más dimensiones donde sí existe una frontera plana que los separa, y lo hace sin calcular explícitamente esas coordenadas nuevas, que sería carísimo. Trabaja solo con las distancias entre pares de puntos, que es lo único que necesita.
El coste de las SVM aparece con el volumen. El entrenamiento escala mal cuando el número de ejemplos crece hasta los millones, y ahí es donde otras familias de algoritmos le comen el terreno.
K-means, agrupar sin saber qué buscas
El único no supervisado de los cuatro. En el capítulo 5 ya apareció el nombre y el papel que cumple, agrupar datos sin etiquetas en clústeres de elementos parecidos entre sí. Aquí toca el mecanismo, que es sorprendentemente corto de explicar.
Eliges cuántos grupos quieres, ese número es la k. El algoritmo coloca k centros en posiciones iniciales, y a partir de ahí repite dos pasos en bucle. Primero, asigna cada punto al centro que tenga más cerca, formando k grupos. Segundo, mueve cada centro al punto medio de todos los puntos que le han tocado. Ese movimiento cambia las distancias, así que algunos puntos ahora quedan más cerca de otro centro, y el bucle vuelve a empezar. Se repite hasta que los centros dejan de moverse. Ahí el algoritmo ha convergido y los grupos están formados.
El origen del procedimiento es un caso curioso de publicación tardía. Stuart Lloyd lo describió en 1957 en un informe técnico interno de Bell Labs, aplicado a un problema de telecomunicaciones que no tenía nada que ver con agrupar clientes, la cuantización de señales en modulación por impulsos codificados. Ese informe no salió como publicación formal hasta 1982, en IEEE Transactions on Information Theory, veinticinco años después. El nombre «k-means» lo acuñó James MacQueen en 1967, en el mismo trabajo del Berkeley Symposium que ya citaba el capítulo anterior.
Las dos debilidades de k-means se deducen de su propio mecanismo. La primera, tú eliges la k, el algoritmo no la descubre. Si le pides tres grupos a unos datos que naturalmente tienen cinco, te dará tres grupos igualmente, sin quejarse. La segunda, el resultado depende de dónde caigan los centros iniciales, así que en la práctica se ejecuta varias veces con distintos puntos de partida y se compara.
Por qué siguen aquí
Queda la pregunta incómoda. Si existen redes neuronales capaces de generar vídeo y escribir código, ¿por qué alguien entrenaría en 2026 un modelo de árboles para predecir la morosidad de una cartera de clientes?
La respuesta tiene respaldo empírico reciente. Léo Grinsztajn, Edouard Oyallon y Gaël Varoquaux publicaron en NeurIPS 2022 un benchmark extenso comparando modelos basados en árboles contra métodos de deep learning sobre datos tabulares, esas tablas de filas y columnas que son el pan de cada día de bancos, aseguradoras, hospitales y comercios. Su conclusión fue que los modelos de árboles siguen siendo el estado del arte en conjuntos de datos de tamaño medio, en torno a diez mil ejemplos, y que la diferencia no se explica solo por las variables categóricas ni desaparece ajustando bien los hiperparámetros de las redes.
A eso se suman razones menos científicas y muy reales. Una regresión logística se entrena en segundos, cabe en cualquier servidor, no necesita una GPU alquilada por horas, y cuando falla puedes averiguar por qué. Un modelo de árboles se puede auditar ante un regulador. Un k-means sobre el histórico de compras responde una pregunta de negocio concreta en una tarde. Elegir un modelo enorme para un problema pequeño no es sofisticación, es gasto.
El capítulo 7 recoge el hilo que este ha dejado suelto varias veces. Da igual qué algoritmos de machine learning elijas de esta caja de herramientas, todos comparten el mismo proceso de entrenamiento y todos pueden caer en la misma trampa, la de memorizar los ejemplos que ya vieron en vez de aprender el patrón que hay debajo.
Fuentes
– J. Ross Quinlan, «Induction of Decision Trees», Machine Learning 1 (1986), pp. 81-106
– Corinna Cortes y Vladimir Vapnik, «Support-Vector Networks», Machine Learning 20 (1995), pp. 273-297
– Tianqi Chen y Carlos Guestrin, «XGBoost: A Scalable Tree Boosting System», KDD (2016)