serie: IA de cero a experto | artículo 2 de 30Me pregunto si esta vez la IA es diferente, si el hype de 2026 va a durar. Y cada vez me acuerdo de que esta pregunta ya se hizo antes. Dos veces, de hecho, y las dos veces la respuesta fue que no, que el dinero se acabó y los laboratorios cerraron las persianas. Este capítulo es la historia de esas dos veces: los llamados «inviernos de la IA», los periodos en los que el campo prometió demasiado, cumplió poco, y pagó el precio en forma de financiación cero.
Conocer esta historia no es un ejercicio de nostalgia. Es la vacuna contra el hype: si sabes por qué se apagaron las luces dos veces antes, puedes juzgar con más criterio si esta vez es distinto, y de paso vas a sonar mucho mejor informada la próxima vez que alguien te diga que la IA generativa lo va a cambiar todo mañana mismo.
1950: la pregunta que lo empezó todo
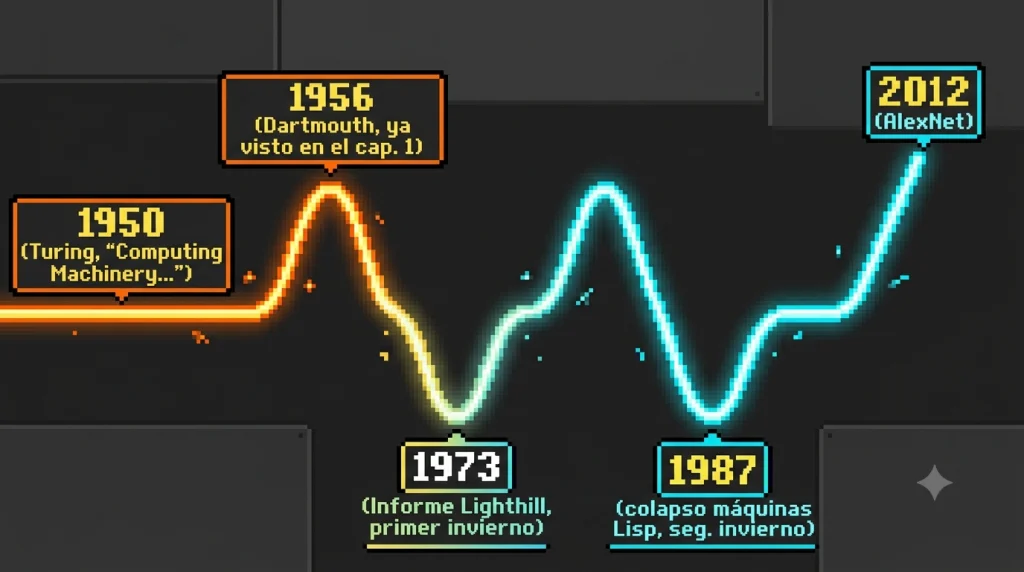
Antes de que existiera el término «inteligencia artificial» (eso llegaría en 1956, como ya vimos en el capítulo anterior), Alan Turing publicó un artículo que sigue siendo lectura obligatoria: «Computing Machinery and Intelligence», en la revista Mind, en 1950. Turing no pregunta «¿pueden pensar las máquinas?» porque considera la pregunta demasiado ambigua para responderla en serio. En su lugar, propone un juego: el «juego de la imitación» (hoy conocido como el test de Turing), en el que un interrogador humano conversa a ciegas con una máquina y con otro humano, sin saber cuál es cuál. Si el interrogador no logra distinguirlos de forma fiable, la máquina «pasa» el test.
Turing incluso se atrevió a poner una fecha y un número. Escribió que creía que en unos cincuenta años sería posible programar ordenadores para que jugaran tan bien al juego de la imitación que un interrogador medio no tuviera más de un 70% de probabilidad de identificar correctamente quién era la máquina tras cinco minutos de preguntas. Traducido: para el año 2000, un interrogador debería confundirse al menos un 30% de las veces. El año 2000 llegó y se fue, y ningún sistema cumplió esa marca. La primera predicción de la historia de la IA ya llevaba en su interior la primera decepción.
Setenta y cinco años después de aquel artículo, seguimos discutiendo si algún sistema ha pasado de verdad ese test, y seguimos usando el marco que Turing propuso para plantear la pregunta. Eso es lo que separa un artículo fundacional de una moda pasajera: la vigencia.
Y aquí va el cierre del círculo, con dato incluido. En 2024, un equipo de investigadores de la Universidad de California San Diego reprodujo el experimento de Turing casi al pie de la letra: alrededor de 500 personas mantuvieron conversaciones de texto de cinco minutos, sin saber si hablaban con un humano o con un sistema. GPT-4 fue identificado como humano en el 54% de las conversaciones, un porcentaje mayor que el de ELIZA, un chatbot de los años 60 que usaron como control y que solo engañó al 22%, aunque todavía por debajo del 67% que lograron los propios humanos haciéndose pasar por humanos. Turing había puesto el listón en un 30% de confusión para el año 2000. Llegó 24 años tarde, pero se cumplió, y de largo.
Conviene un matiz antes de sacar pecho en nombre de la IA: pasar el test de Turing demuestra que un sistema puede imitar bien una conversación humana durante cinco minutos, no que piense, entienda o sea consciente en ningún sentido profundo de esas palabras. El propio Turing diseñó el juego precisamente para esquivar esa pregunta filosófica, no para responderla. Es una prueba de comportamiento, no de naturaleza interna, una distinción a la que voy a volver en la fase 3 de esta serie.
1956-1973: la euforia inicial
Con el término ya acuñado en Dartmouth, los primeros años de la IA como campo formal fueron de optimismo casi ilimitado, y no hablo en sentido figurado: hablo de fechas y porcentajes concretos, publicados por los propios fundadores del campo, que no se cumplieron ni de lejos. En 1965, Herbert Simon, uno de los asistentes al taller de Dartmouth y futuro premio Nobel, escribió que las máquinas serían capaces, en veinte años, de hacer cualquier trabajo que un humano pudiera hacer. Marvin Minsky, otro de los padres fundadores del campo, fue todavía más lejos: en 1967 predijo que en una generación el problema de crear inteligencia artificial estaría sustancialmente resuelto, y en una entrevista para la revista Life en 1970 concretó aún más, afirmando que en un plazo de tres a ocho años tendríamos una máquina con la inteligencia general de un humano medio.
Ninguna de las tres predicciones se cumplió en el plazo prometido. Y este patrón (prometer una fecha concreta y muy cercana para un logro que en realidad tardaría décadas, o que todavía no ha llegado) es exactamente el mecanismo que un par de años después empezaría a pasarle factura al campo entero.
Uno de los primeros golpes a ese optimismo llegó por un flanco muy concreto: la traducción automática. En 1966, el comité ALPAC, encargado por el gobierno de Estados Unidos de evaluar los avances en traducción automática tras años de inversión, publicó un informe demoledor: la traducción automática no estaba a la altura de lo prometido, era más lenta y más cara que la traducción humana, y no había perspectivas claras de que fuera a mejorar pronto. El resultado fue el fin casi total de la financiación pública a la investigación en traducción automática en Estados Unidos durante años.
ALPAC fue el aviso, limitado a un subcampo concreto. Lo que vino después fue el golpe de gracia, y esta vez a todo el campo.
El primer invierno (1973-1980): el informe que apagó las luces
En 1973, el matemático británico Sir James Lighthill entregó al Science Research Council del Reino Unido un informe encargado para evaluar el estado de la investigación en IA. La conclusión de Lighthill fue dura: gran parte de la IA académica no había cumplido sus promesas, y muchos de los problemas que el campo intentaba resolver sufrían lo que llamó «explosión combinatoria»: el número de posibilidades a explorar crecía de forma exponencial en cuanto el problema dejaba de ser un juguete de laboratorio y se acercaba a la escala del mundo real.
El informe Lighthill tuvo un efecto inmediato: el gobierno británico recortó drásticamente la financiación a la investigación en IA, dejando a la mayoría de universidades del Reino Unido sin apoyo para este campo. El golpe no se quedó en las islas británicas. El informe se convirtió en munición para los escépticos en todo el mundo, y contribuyó a que la DARPA estadounidense redujera de forma notable su apoyo a la investigación en IA a partir de 1974.
Este periodo, aproximadamente entre 1973 y 1980, es lo que la comunidad conoce como el primer invierno de la IA. Los laboratorios que sobrevivieron lo hicieron con presupuestos mínimos y expectativas mucho más modestas que las de Simon o Minsky una década antes.
El segundo invierno (1987-1993): cuando el hardware de IA se volvió chatarra de la noche a la mañana
Los años 80 trajeron un resurgir real: los sistemas expertos. Programas construidos a partir de cientos o miles de reglas escritas por especialistas humanos, como MYCIN, el sistema de diagnóstico médico que ya conociste en el capítulo 1, demostraron que la IA sí podía generar valor comercial concreto en dominios acotados. Empresas enteras se construyeron alrededor de esta idea, y con ellas nació un mercado de hardware especializado: las llamadas «máquinas Lisp», ordenadores diseñados específicamente para ejecutar programas de IA, vendidos por compañías como Symbolics o LMI a precios muy superiores a los de un ordenador normal.
El problema fue doble. Por un lado, los sistemas expertos resultaron ser frágiles y carísimos de mantener: cada actualización del conocimiento requería contratar a un ingeniero especializado para reescribir reglas a mano, un cuello de botella conocido como el «problema de adquisición de conocimiento». Un sistema experto no aprendía nada nuevo por sí mismo, como ya vimos en el capítulo 1: si el mundo cambiaba, alguien tenía que sentarse a reescribir las reglas. Por otro lado, el hardware especializado dejó de tener sentido económico en cuanto estaciones de trabajo genéricas, mucho más baratas, de compañías como Apple o Sun Microsystems alcanzaron un rendimiento comparable. El mercado de las máquinas Lisp se desplomó entre 1987 y 1988.
El golpe simbólico llegó del propio gobierno estadounidense: en 1987, Jack Schwartz, entonces responsable de la oficina de ciencia de la información en DARPA, descartó los sistemas expertos calificándolos de «programación ingeniosa» más que de inteligencia real. Casi en paralelo, el ambicioso proyecto japonés de «quinta generación» de ordenadores terminó sin alcanzar sus metas. Este segundo invierno, que se extendió aproximadamente de 1987 a 1993, golpeó más fuerte que el primero porque esta vez había una industria comercial real detrás, con empleos e inversores reales que perder.
El detalle irónico: la semilla del deep learning se plantó durante el invierno
Aquí va el dato que más me gusta de todo el capítulo, el que demuestra que la historia de la IA nunca es tan lineal como parece contada con prisa. En 1986, en pleno ascenso de los sistemas expertos y justo antes de que el mercado se desplomara, David Rumelhart, Geoffrey Hinton y Ronald Williams publicaron en la revista Nature un artículo titulado «Learning representations by back-propagating errors». En él describían el algoritmo de retropropagación (backpropagation), un método para entrenar redes neuronales de varias capas ajustando los pesos de sus conexiones para minimizar el error entre lo que la red predice y lo que debería predecir.
La técnica que hoy entrena prácticamente todos los modelos de deep learning del planeta, la misma que verás con detalle en el capítulo 11, se publicó, literalmente, en el ojo del huracán del segundo invierno de la IA. No tenía la potencia de cálculo ni los datos necesarios para demostrar todo su potencial en 1986. Tuvo que esperar 26 años, viendo pasar un invierno entero, a que el resto de las piezas encajaran.
2012: la foto que descongeló todo
Esas piezas encajaron en la competición ImageNet Large Scale Visual Recognition Challenge, un concurso anual en el que distintos sistemas compiten por clasificar correctamente millones de fotografías en miles de categorías. Hasta ese año, los mejores sistemas rondaban una tasa de error del 25-26%, combinando características de imagen diseñadas a mano con clasificadores estadísticos tradicionales, el tipo de IA clásica que viste en el capítulo 1.
Ese año, un equipo formado por Alex Krizhevsky, Ilya Sutskever y Geoffrey Hinton (el mismo Hinton del artículo de 1986) presentó un sistema llamado AlexNet: una red neuronal profunda de ocho capas, con unos 60 millones de parámetros, entrenada usando precisamente backpropagation, pero esta vez sobre GPUs y con acceso a millones de imágenes etiquetadas gracias al propio proyecto ImageNet. El resultado: una tasa de error del 15,3%, una mejora de casi 11 puntos porcentuales sobre el segundo mejor sistema en un solo año de competición. La comunidad de visión por computador se quedó, literalmente, sin palabras.
AlexNet no inventó nada conceptualmente nuevo: el backpropagation llevaba 26 años publicado, y las redes convolucionales llevaban años existiendo en papers académicos. Lo que cambió fue que, por primera vez, existían a la vez los tres ingredientes necesarios para que la idea funcionara a escala: datos masivos etiquetados, potencia de cálculo barata, y una arquitectura bien ajustada. Ese momento marca el final de facto de los inviernos de la IA y el arranque de la década que llevó, en línea prácticamente recta, hasta los modelos de lenguaje que vas a ver en la fase 3 de esta serie.
Por qué esto importa en 2026
Los dos inviernos, vistos con perspectiva, no fueron solo mala suerte. Comparten un patrón que se repite con variaciones: alguien pone una fecha concreta y optimista a un problema que en realidad es mucho más difícil de lo que parece desde fuera, esa fecha se convierte en el titular que todo el mundo repite, y cuando la fecha llega sin que el problema esté resuelto, la decepción no se queda solo en el logro incumplido, contamina la credibilidad de todo el campo, incluidos los avances que sí eran reales. Simon no mintió a propósito. Minsky tampoco. Ambos subestimaron genuinamente la dificultad del problema, algo que sigue pasando hoy con bastante regularidad cuando alguien pone fecha a la llegada de una inteligencia artificial general.
La diferencia real entre 2026 y 1973 o 1987 es que ahora hay ingresos reales, productos usados por miles de millones de personas y un ecosistema económico mucho más diversificado que dos laboratorios de universidad y un puñado de contratos gubernamentales. Eso no hace imposible una corrección fuerte del hype actual. Solo hace que, si llega, probablemente no se parezca a los inviernos anteriores.
En el próximo capítulo dejamos la historia y volvemos al mapa: qué tipos de IA existen (estrecha, general, superinteligencia) y por qué casi todo lo que hoy llamamos «IA», incluido todo lo que has leído en este capítulo, cae, sin excepción, en la primera categoría.
Fuentes
- Computing Machinery and Intelligence, A. M. Turing, Mind, 1950 (texto completo)
- The Turing Test (Stanford Encyclopedia of Philosophy)
- People cannot distinguish GPT-4 from a human in a Turing test (arXiv / ACM FAccT 2025)
- Quote Origin: Machines Will Be Capable, Within Twenty Years… (Quote Investigator, sobre Herbert Simon)
- Quote Origin: Within a Generation… the Problems of Creating Artificial Intelligence Will Be Substantially Solved (Quote Investigator, sobre Marvin Minsky)
- AI Winter: Understanding the Cycles of AI Development (DataCamp)
- The Second AI Winter (1987–1993) — Making Things Think (Holloway)
- Learning representations by back-propagating errors, Rumelhart, Hinton y Williams, Nature, 1986
- ImageNet Classification with Deep Convolutional Neural Networks, Krizhevsky, Sutskever y Hinton, NeurIPS 2012