serie: IA de cero a experto | artículo 5 de 30Tres formas distintas de aprender: con respuestas correctas, sin ellas, o por ensayo y error.
Tres formas de aprender
En 1959, Arthur Samuel, ingeniero de IBM, publicó un artículo con un título que hoy suena a evidencia y entonces era una novedad completa: «Some Studies in Machine Learning Using the Game of Checkers». Ahí aparece, por primera vez documentada, la expresión «machine learning»: un programa que jugaba a las damas y que, en vez de seguir reglas fijas escritas a mano, mejoraba su juego partida a partida, comparando sus propias posiciones contra un archivo de resultados pasados. Samuel lo definió con una frase que sigue siendo la mejor definición corta que existe: la capacidad de un ordenador de aprender sin haber sido programado explícitamente para la tarea concreta que termina resolviendo.
Sesenta y siete años después, «machine learning» ya no es una curiosidad de laboratorio de IBM, es la fase 1 de esta serie, y el terreno donde vive casi todo lo que hoy llamamos IA «seria» (la que no es un sistema experto ni un algoritmo con reglas fijas, del tipo que viste en el capítulo 1). Pero antes de meternos en algoritmos concretos en el capítulo 6, hace falta un mapa de los tipos de aprendizaje en IA: las tres formas fundamentalmente distintas en las que una máquina puede aprender, supervisado, no supervisado y por refuerzo. No son tres algoritmos, son tres escuelas de pensamiento, tres tipos de problema que exigen enfoques distintos, y casi todo lo que vas a ver en el resto de esta serie encaja en una de las tres. Cada una asume una cantidad y un tipo de información distinta disponible de partida (ejemplos ya resueltos, ejemplos sin resolver, o ninguna de las dos cosas y solo la posibilidad de actuar y observar el resultado), y esa asunción de partida determina qué algoritmos tienen sentido usar y cuáles no, mucho antes de escribir una sola línea de código.
Aprendizaje supervisado
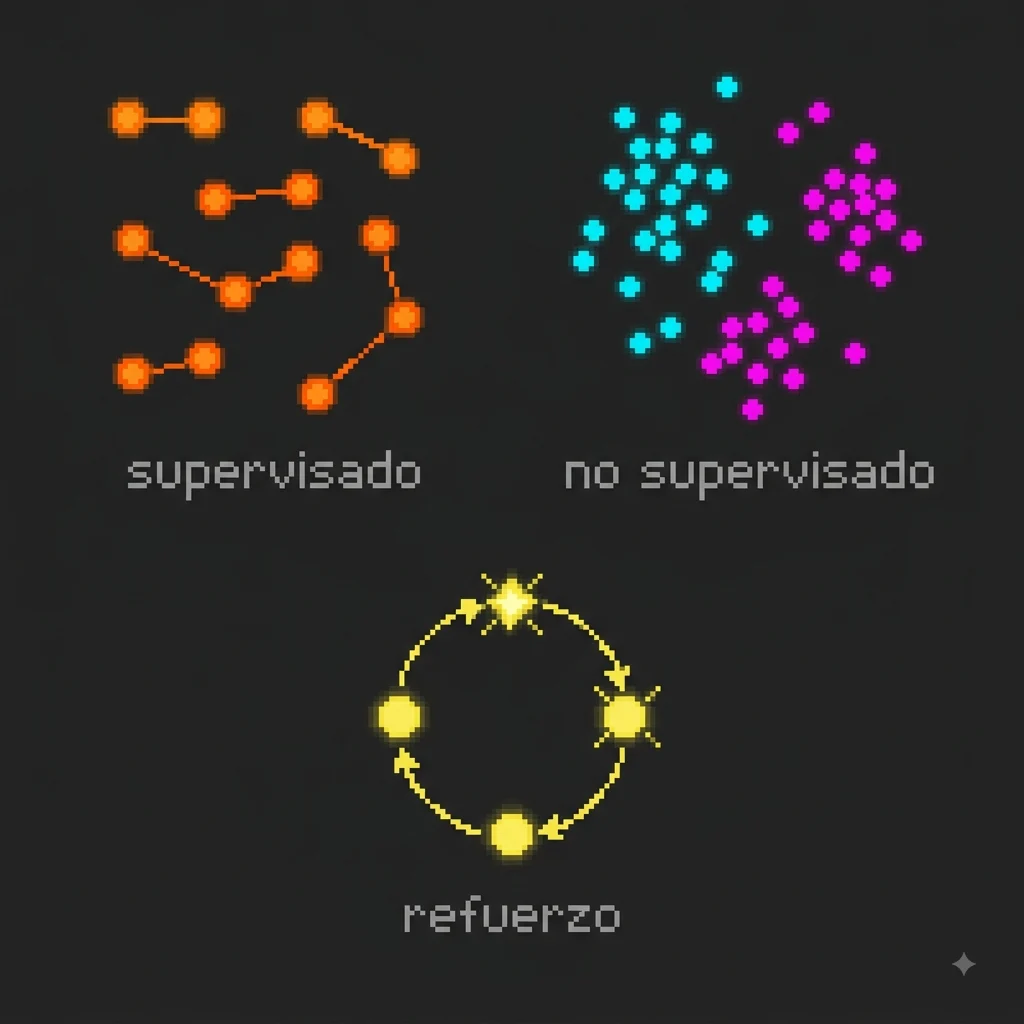
El aprendizaje supervisado es, con diferencia, el más intuitivo de los tres, y también el más usado en aplicaciones reales. La idea de fondo: le enseñas al modelo un montón de ejemplos ya resueltos, cada uno con su respuesta correcta adjunta, y el modelo aprende a generalizar el patrón para poder responder ante ejemplos nuevos que nunca vio. «Supervisado» no se refiere a que un humano vigile el entrenamiento en tiempo real, se refiere a que los datos de entrenamiento ya vienen etiquetados con la respuesta correcta, como un examen con las soluciones al lado.
El filtro de spam de los capítulos 1 y 4 es aprendizaje supervisado de manual: se entrena con miles de correos ya clasificados a mano como «spam» o «no spam», el modelo aprende qué patrones (palabras, remitentes, estructura) se asocian con cada etiqueta, y cuando llega un correo nuevo sin etiquetar, predice a cuál de las dos categorías pertenece. Este tipo de problema, donde la respuesta es una de varias categorías fijas, se llama clasificación. Hay una segunda familia dentro del aprendizaje supervisado, la regresión, donde en vez de predecir una categoría se predice un número: el precio de una vivienda a partir de su tamaño, ubicación y antigüedad, o los ingresos estimados de una empresa el próximo trimestre. Clasificación y regresión son, en el fondo, la misma idea (aprender de ejemplos etiquetados) aplicada a dos tipos distintos de pregunta, «¿cuál de estas categorías?» frente a «¿qué número?». Otro ejemplo de clasificación, menos citado que el spam pero igual de cotidiano: un sistema que revisa una radiografía y predice si hay o no indicios de una fractura, entrenado con miles de radiografías previas ya diagnosticadas por radiólogos humanos. Cuando llegues al capítulo 12 sobre redes convolucionales verás cómo se hace esto concretamente con imágenes, pero el principio de fondo (ejemplos etiquetados, patrón aprendido, predicción sobre casos nuevos) es exactamente el mismo que el filtro de spam.
El coste de este enfoque es precisamente lo que lo hace potente: alguien, en algún momento, tuvo que etiquetar todos esos datos a mano. Etiquetar miles o millones de ejemplos con la respuesta correcta es caro, lento, y a veces requiere experiencia especializada (un radiólogo etiquetando radiografías, no un becario). Esta limitación, más que cualquier otra, es la que empuja a la industria hacia los otros dos paradigmas cuando etiquetar a mano deja de ser viable a la escala que hace falta.
No basta con que el modelo acierte en los ejemplos que ya vio durante el entrenamiento, lo que de verdad importa es que acierte en ejemplos nuevos que nunca vio, una distinción a la que vas a volver con nombre propio en el capítulo 7. Por eso, en la práctica, los datos etiquetados nunca se usan todos para entrenar: una parte se reserva aparte, sin tocar, para comprobar después si el modelo realmente aprendió el patrón general o si simplemente memorizó los ejemplos concretos que le enseñaron.
Aprendizaje no supervisado
El aprendizaje no supervisado invierte el planteamiento: no hay respuestas correctas adjuntas a los datos, no hay etiquetas de ningún tipo. El modelo recibe un montón de ejemplos sin resolver y tiene que encontrar, por su cuenta, estructura o patrones ocultos en ellos. Nadie le dice «esto es un cliente tipo A y esto es un cliente tipo B», el propio algoritmo decide cuántos grupos tiene sentido formar y qué ejemplos van en cada uno, basándose únicamente en cómo de parecidos son entre sí.
La tarea más común dentro de este paradigma es la agrupación o clustering, y el algoritmo de referencia es k-means, descrito formalmente en 1967 por James MacQueen en «Some Methods for Classification and Analysis of Multivariate Observations», presentado en el Berkeley Symposium on Mathematical Statistics and Probability. La intuición es simple: dado un conjunto de puntos (clientes, imágenes, lo que sea, ya representados como vectores, como viste en el capítulo 4), el algoritmo los reparte en k grupos de forma que los puntos dentro de un mismo grupo queden lo más cerca posible entre sí. Verás el mecanismo exacto, paso a paso, en el capítulo 6. Aquí basta con la idea: una tienda online puede usar clustering sobre el historial de compras de sus clientes (qué compran, cuánto gastan, cada cuánto vuelven) para descubrir, sin que nadie se lo diga de antemano, que existen grupos naturales de compradores con hábitos parecidos, por ejemplo compradores ocasionales de producto caro frente a compradores frecuentes de ticket bajo, y adaptar sus campañas a cada grupo por separado. Nadie decidió de antemano cuántos grupos existían ni qué características los definían, el algoritmo los encontró solo, a partir de la estructura de los propios datos.
Otra tarea habitual del aprendizaje no supervisado es la detección de anomalías: en vez de agrupar, el objetivo es identificar qué ejemplos se salen del patrón general del resto. Un banco puede entrenar un modelo con el histórico de transacciones legítimas de una cuenta (sin ninguna etiqueta de «esto es fraude»), y usarlo después para marcar como sospechosa cualquier transacción que se aleje demasiado del comportamiento habitual de esa cuenta. Nadie tuvo que etiquetar miles de casos de fraude confirmado para que el sistema funcione, que es exactamente la limitación que el aprendizaje supervisado no resolvía bien.
Una tercera tarea no supervisada, menos vistosa pero igual de usada, es la reducción de dimensionalidad: tomar datos representados con muchísimas variables (recuerda los vectores de miles de números del capítulo 4) y comprimirlos en una versión más pequeña que conserve la información esencial, útil tanto para visualizar datos complejos en un gráfico de dos ejes como para acelerar el entrenamiento de otros modelos que vengan después.
Aprendizaje por refuerzo
El tercer paradigma es el más distinto de los dos anteriores, y también el que más se parece, de forma literal, a cómo aprende un animal por ensayo y error. No hay ejemplos etiquetados de antemano (como en el supervisado) ni un conjunto de datos fijo del que extraer patrones (como en el no supervisado). En su lugar hay un agente que actúa dentro de un entorno, recibe una recompensa (positiva o negativa) después de cada acción, y ajusta su comportamiento con el único objetivo de maximizar la recompensa acumulada a lo largo del tiempo. El marco formal de este paradigma, con su terminología estándar (agente, entorno, estado, acción, recompensa, política), quedó establecido en el libro de referencia del campo, «Reinforcement Learning: An Introduction», de Richard Sutton y Andrew Barto, publicado por primera vez en 1998 y hoy el texto que cualquier curso serio de la materia usa como base. Con un ejemplo sencillo, sin tablero de Go de por medio: un robot aspirador que aprende solo, por refuerzo, sería un agente que en cada momento observa su posición y el estado de la habitación (el estado), decide moverse en una dirección o activar la succión (la acción), recibe una recompensa positiva pequeña por cada zona limpiada y una penalización si choca contra un mueble o se queda sin batería lejos de su base, y con el tiempo, jugada tras jugada, ajusta su estrategia general (la política) para maximizar la recompensa acumulada de la sesión completa. Nadie le programó la ruta óptima a mano, la fue descubriendo por prueba y error, exactamente igual que AlphaGo descubrió sus jugadas.
El caso más citado de aprendizaje por refuerzo aplicado a gran escala es AlphaGo, el sistema de DeepMind que en 2016 derrotó a Lee Sedol, campeón mundial de Go, un juego considerado durante décadas demasiado complejo para que una máquina lo dominara por la explosión combinatoria de movimientos posibles. El propio equipo de DeepMind, liderado por David Silver, publicó los detalles técnicos en Nature («Mastering the Game of Go with Deep Neural Networks and Tree Search», 2016): AlphaGo combinaba aprendizaje supervisado inicial (partidas de jugadores humanos expertos, para arrancar con un nivel razonable) con aprendizaje por refuerzo posterior, jugando millones de partidas contra sí mismo y ajustando su estrategia según ganaba o perdía cada una. Esa combinación de los dos primeros paradigmas para entrenar el tercero, en vez de tratarlos como cajas completamente separadas, es una idea a la que vas a volver a ver una y otra vez en el resto de esta serie. Dos años después, el mismo equipo fue un paso más allá con AlphaZero (publicado también en Science, «A General Reinforcement Learning Algorithm That Masters Chess, Shogi, and Go Through Self-Play», 2018): esta segunda versión ni siquiera arrancaba con partidas humanas de referencia, aprendía ajedrez, shogi y Go desde cero, solo a partir de las reglas del juego y de jugar contra sí misma millones de veces, aprendizaje por refuerzo puro sin la muleta inicial del supervisado.
Fuera de los juegos, el aprendizaje por refuerzo también es la base conceptual de buena parte de la robótica moderna (un brazo robótico que aprende a agarrar objetos de formas distintas por prueba y error simulado) y de los sistemas de recomendación más sofisticados, donde el «entorno» es el propio usuario y la «recompensa» es que haga clic, vea el vídeo entero o vuelva al día siguiente. Vale la pena un matiz honesto sobre este último ejemplo: un sistema entrenado para maximizar clics o tiempo de visualización no tiene ningún mecanismo interno que distinga «contenido que le interesa genuinamente al usuario» de «contenido que engancha aunque no le convenga», porque ambos generan la misma recompensa medible. Este fenómeno, cuando un sistema optimiza exactamente la métrica que se le pidió pero de una forma que nadie quería, se conoce como reward hacking o specification gaming, y es uno de los problemas centrales del capítulo sobre seguridad y alineación de la fase 4.
Las tres escuelas no son compartimentos completamente estancos, como ya viste con AlphaGo. Existe también una zona intermedia entre supervisado y no supervisado, el aprendizaje semi-supervisado (una pequeña porción de datos etiquetados junto a una gran masa sin etiquetar) y su primo más relevante para el resto de esta serie, el aprendizaje autosupervisado, donde el propio dato genera su etiqueta sin intervención humana, por ejemplo tapando una palabra de una frase y pidiéndole al modelo que la adivine a partir del contexto. Ese último truco, aparentemente simple, es exactamente el mecanismo que hace posible entrenar los modelos de lenguaje que vas a ver en la fase 3 de esta serie, sin que nadie haya tenido que etiquetar a mano ni una fracción de todo el texto de internet que consumen. Es, en cierto modo, el paradigma que resuelve el problema con el que arrancaba la sección de aprendizaje supervisado: si etiquetar datos a mano es el cuello de botella, el aprendizaje autosupervisado hace que el propio texto, ya existente y disponible en cantidades enormes, se etiquete a sí mismo.
Cómo elegir
¿Cómo saber, ante un problema nuevo, cuál de los tipos de aprendizaje aplica? La pregunta práctica de partida no es «¿qué algoritmo suena más avanzado?», es mucho más aburrida que eso:
¿Tienes datos ya etiquetados con la respuesta correcta? Si es que sí, supervisado.
¿Tienes datos, pero nadie los ha etiquetado y probablemente etiquetarlos a mano sería carísimo o imposible? No supervisado.
¿No tienes ni siquiera un conjunto de datos fijo, sino un sistema que puede actuar y recibir una señal de éxito o fracaso después de cada acción, en un entorno que responde a lo que hace? Refuerzo.
La elección del paradigma casi nunca depende de preferencias técnicas, depende de qué forma tienen los datos y el problema que hay encima de la mesa.
Con este mapa de las tres escuelas ya en su sitio, el próximo capítulo baja al terreno concreto: los algoritmos clásicos (regresión, árboles de decisión, SVM, k-means) que llevan décadas resolviendo problemas reales de aprendizaje supervisado y no supervisado, mucho antes de que ninguna red neuronal entrara en escena.
Fuentes
- Arthur Samuel, «Some Studies in Machine Learning Using the Game of Checkers», IBM Journal of Research and Development (1959)
- James MacQueen, «Some Methods for Classification and Analysis of Multivariate Observations», Proceedings of the Fifth Berkeley Symposium on Mathematical Statistics and Probability (1967)
- Richard S. Sutton y Andrew G. Barto, «Reinforcement Learning: An Introduction», MIT Press
- David Silver et al., «Mastering the Game of Go with Deep Neural Networks and Tree Search», Nature 529 (2016)
- David Silver et al., «A General Reinforcement Learning Algorithm That Masters Chess, Shogi, and Go Through Self-Play», Science 362 (2018)